Thesis
Automatisierte Kuratierung der Wissensdatenbank eines RAG-basierten Support-Chatbots mittels LLM-basierter Methoden
Warum eine Wissensbasis kuratiert werden muss
Large Language Models können Chatbots flexibler machen, verfügen aber nicht automatisch über alle Informationen eines Unternehmens. Retrieval-Augmented Generation (RAG) ergänzt deshalb eine Anfrage um passende Inhalte aus einer Wissensbasis. Bei den Stadtwerken Norderstedt bildet ein fortlaufend erweiterter FAQ-Katalog die Grundlage eines solchen Service-Chatbots. Mit wachsender und häufig veränderter Datenmenge ist eine rein manuelle Prüfung jedoch nur eingeschränkt möglich.
Die Arbeit untersucht daher, ob Sprachmodelle bestehende Wissenseinträge automatisch überarbeiten können, sodass für die Antwortgenerierung weniger Kontext bereitgestellt werden muss, ohne den fachlichen Informationsgehalt wesentlich zu verringern. Betrachtet wird ausschließlich der Retrieval-Teil des Systems.
Drei Ansätze zur automatisierten Kuratierung
- A Text Compression: entfernt redundante, irrelevante oder informationsarme Textbestandteile aus einzelnen Einträgen.
- B Semantic Deduplication: identifiziert semantisch ähnliche Einträge und führt geeignete Inhalte zusammen.
- C Chunk Splitting: teilt umfangreiche Einträge in kleinere, inhaltlich trennbare Einheiten.
Als Datengrundlage dienen 790 von Fachabteilungen verfasste Frage-Antwort-Paare. Nach der Kuratierung wird für jede Variante erneut geprüft, welche Inhalte das Retrieval bereitstellt. Context Relevance misst, ob einzelne abgerufene Textabschnitte zur Anfrage passen. Context Sufficiency bewertet, ob der Kontext insgesamt genügend Informationen für eine Antwort enthält. Ergänzend werden Textmenge, Chunk-Anzahl und Kompressionsverhältnisse betrachtet. Für die inhaltliche Bewertung kommt ein LLM-as-a-Judge-Ansatz zum Einsatz.
Ergebnisse: Textkompression reduziert am stärksten
Prozentangaben: Veränderung gegenüber dem Original. Textumfang jeweils in Zeichen.
| Methode | Wissensbasis | relevanter Kontext je Query | unzureichender Kontext |
|---|---|---|---|
| Original | 225.315 Zeichen | 748,29 Zeichen | 18 von 790 Queries |
| Text Compression | 162.672 (-27,8 %) | 487.986 (-34,79 %) | 21 von 790 Queries |
| Semantic Deduplication | 202.685 (-10,0 %) | 767.940 (+2,63 %) | 19 von 790 Queries |
| Chunk Splitting | 221.450 (-1,72 %) | 672.188 (-10,0 %) | 22 von 790 Queries |
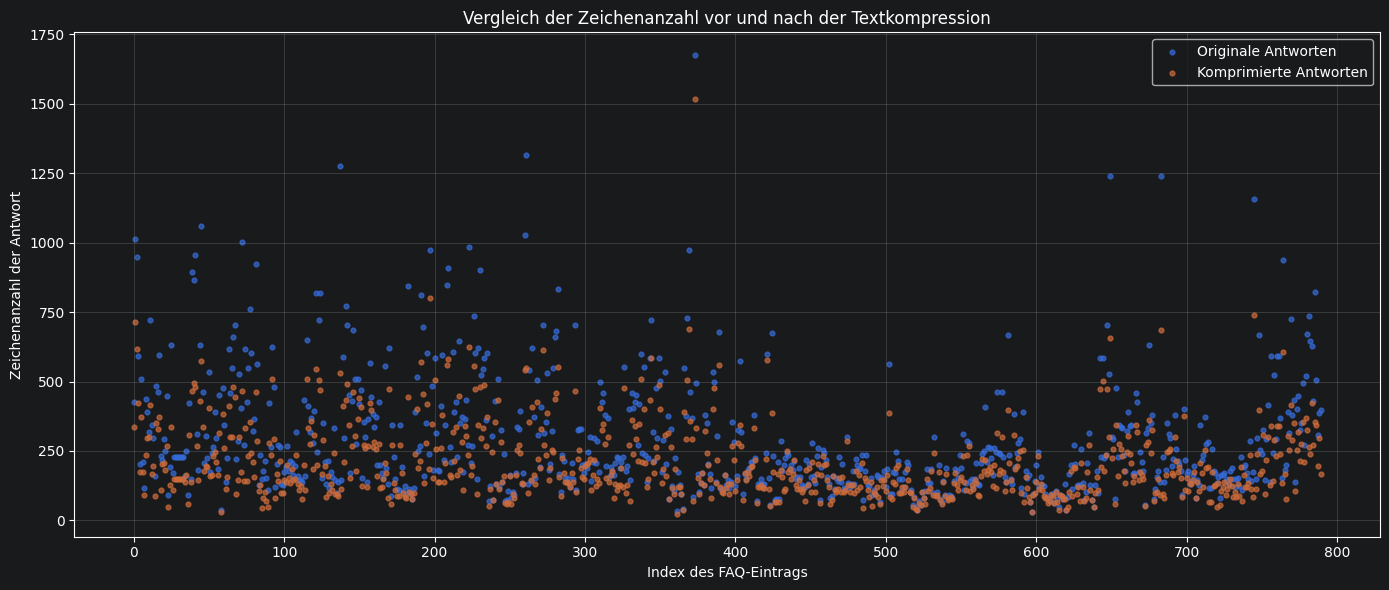
Text Compression verringert sowohl die gesamte Wissensbasis als auch den tatsächlich relevanten Kontext am deutlichsten. Abbildung 1 zeigt den Vergleich der Antwortlängen je FAQ-Eintrag. 94,6 Prozent der Einträge werden kürzer. Chunk Splitting reduziert den relevanten Kontext um etwa zehn Prozent und sorgt zugleich für eine gleichmäßigere Verteilung der Eintragsgrößen. Semantic Deduplication verkleinert zwar die Wissensbasis und reduziert die Zahl der Chunks von 790 auf 648, erhöht aber die relevante Kontextgröße im Retrieval leicht. Eine kleinere Datenbasis führt folglich nicht automatisch zu einem kleineren abgerufenen Kontext.
Fazit und Ausblick
LLM-basierte Kuratierung kann RAG-Wissensbasen effizienter gestalten. Besonders die Textkompression zeigt deutliches Potenzial. Die Informationsqualität bleibt jedoch nicht vollständig unverändert: Gegenüber 18 unzureichenden Kontexten im Ausgangszustand werden nach der Kuratierung je nach Methode 19 bis 22 Fälle ermittelt. Deshalb sollte jede Kuratierung anschließend mit quantitativen und qualitativen Metriken evaluiert werden.
Die Ergebnisse sind vorsichtig zu interpretieren. LLM-as-a-Judge ist nicht deterministisch und kann durch Modell, Biases und Promptgestaltung beeinflusst werden. Zudem bezieht sich die Evaluation auf den verwendeten FAQ-Katalog und nicht auf die Qualität generierter Antworten. Weitere Untersuchungen könnten deshalb die Antwortqualität, andere Sprachmodelle sowie strukturelle Ansätze wie Knowledge Graphs, hierarchische Indexstrukturen oder zusätzliche Metadaten einbeziehen.